こんにちは!レイです。AIを使ってWASHABIというバーチャルバンドのプロデュースをしています。
曲の合いの手やイントロの掛け声、MVの中のちょっとしたセリフなど、歌(Suno)とは別に「メンバーの話し声」を入れたくなる場面もあります。
このとき、既存の読み上げボイスから適当な声を探して使うこともできますが、バンドの歌やMVに合わせて声を入れる場合、実際のボーカルの歌声と近い声質でないと違和感が出てしまいます。そのため、メンバー固有の「話し声」を作って固定しておく必要があります。
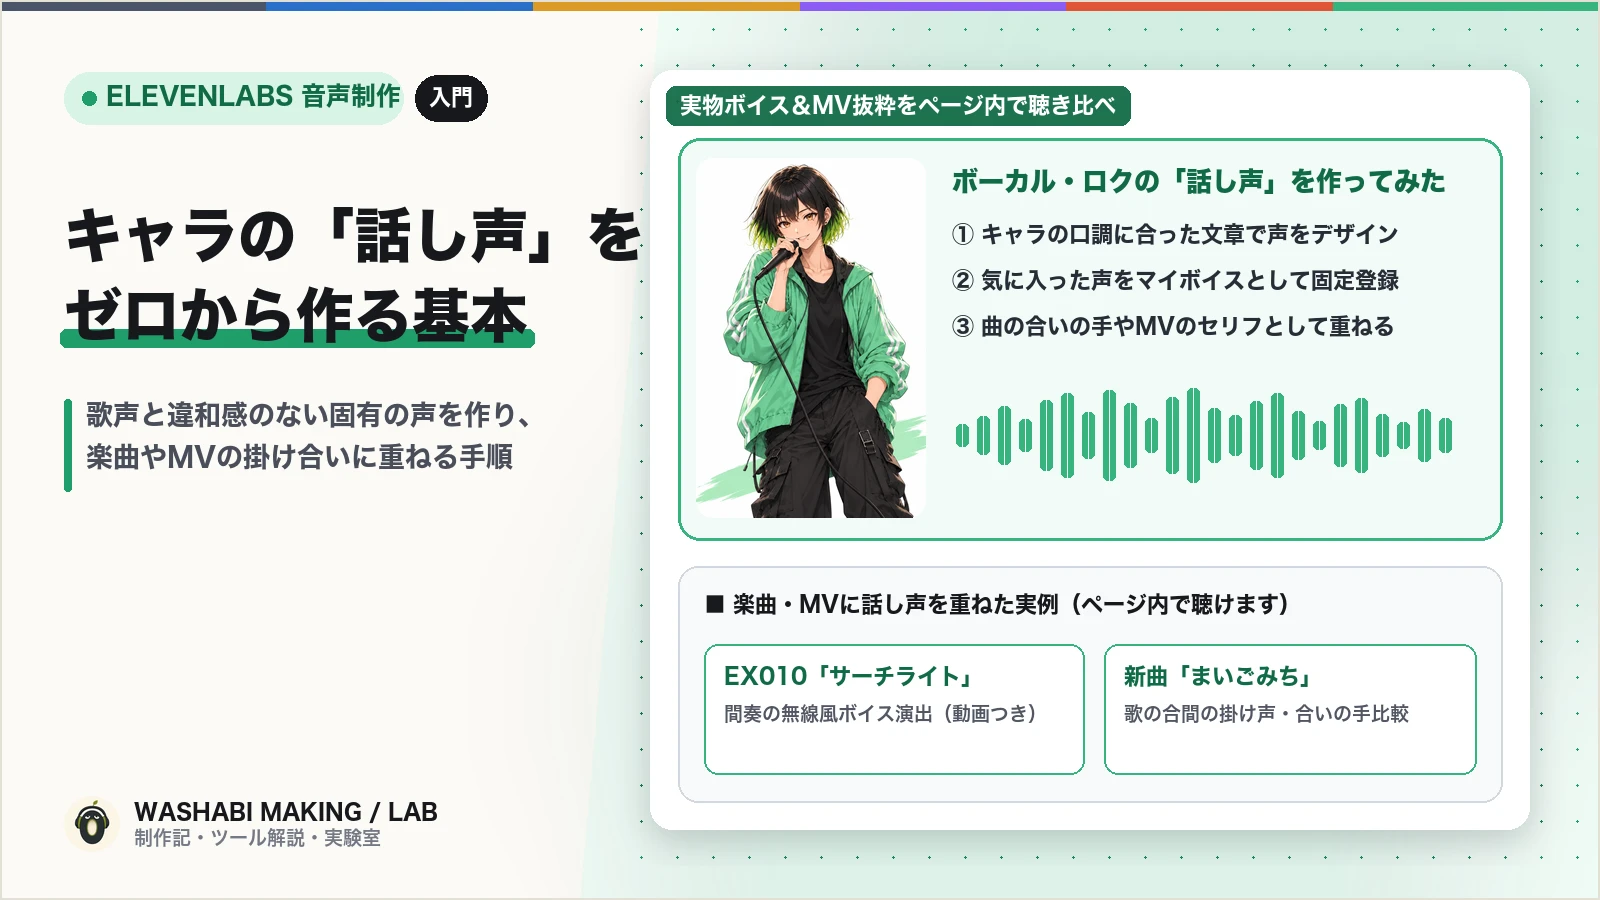
そこで今回は、音声AIの定番 ElevenLabs(イレブンラボ) を使って、ゼロからキャラクターの「話し声」を作り、楽曲の合いの手やMVに重ねるための基本をまとめました。
1. まずは完成形:楽曲・MVに「話し声」を重ねた2つの実例
具体的な作り方の前に、実際にElevenLabsで作ったボーカル・ロク(ROKU)の「話し声」を、WASHABIの楽曲やMVに重ねた2つの実例を聴いてみてください。
実例①:EX010「サーチライト (Heavy Arrange)」の間奏ラジオボイス
重厚なヘヴィロックにリアレンジした「サーチライト」のMVでは、歌の背後(2〜8秒付近)とサビ直後のブレイク(15〜17.5秒付近)に、ElevenLabsで生成したロクの英語セリフ("We are still here... alive, but invisible.")を無線ラジオ風に加工して重ねています(画面下部の緑の波形 RADIO SIG // EX-010 がラジオボイスに連動しています)。
2〜8秒の歌の背後と、15〜17.5秒のブレイク部分に、ElevenLabsで作ったロクの英語ラジオボイス("Alive, but invisible.")を無線風にフィルター加工して重ねています。
実例②:新曲「まいごみち」(※2026年10月30日公開予定・先行抜粋)の掛け声・合いの手
ポップなモータウン調の新曲「#033 まいごみち」(2026年10月30日公開予定)では、Sunoで生成したロクの歌声の合間に、ElevenLabsで作ったロクの話し声(「わかんない」「ハロー」「たぶんね」「んー」「いい風」「いい匂い…」などの合いの手)を重ねています。
歌声と話し声の声質を揃えてあるので、「歌っている本人がそのまま合いの手を入れている」ように自然に馴染みます。
2. ElevenLabsのプランと準備(初めての人向け)
ElevenLabs(elevenlabs.io)を初めて触る人向けに、最初に押さえておきたいプランと環境の要点を整理しておきます。
| 項目 | 内容・注意点 |
|---|---|
| おすすめプラン | Starterプラン(月額 \$5)。無料プラン(Free)は商用利用不可+クレジット表記必須なので、YouTubeやTikTokで公開する作品に使うならStarter以上が安心です |
| 月間クレジット | Starterで 月40,000クレジット(日本語のセリフ読み上げなら1文字≒1クレジット。短い掛け声なら1テイク数十クレジットで済みます) |
| マイボイスの枠 | Starterは 最大10枠。ボイスライブラリの声を試聴・追加すると枠を消費するので、使わない候補はこまめに整理します |
| 出力音質 | Starterは MP3 (44.1kHz / 128kbps) まで。DAWに読み込んで合いの手として混ぜる用途なら十分使えます(非圧縮WAVが欲しい場合はPro以上) |
- 声の説明文(プロンプト)に実在の歌手・声優の名前は絶対に入れない
- ボイスライブラリの既製ボイスをクローン元にしない(クローン元は自分たちでVoice Design生成した音声だけにする)
- Sunoの歌声から直接クローンを作らない
3. 基本の作り方:Voice Designでゼロから声を作るステップ
ElevenLabsには、テキストの説明文から新しい声を生成する 「Voice Design(ボイスデザイン)」 と、作った声の高さやテンポを微調整する 「Voice Remix(ボイスリミックス)」 という機能があります。
声を作るときの基本ステップは次の3つです。
1. 「声の説明文(英語プロンプト)」を用意する
- 年代、性別、声の高さ、話すテンポ、雰囲気(落ち着いた、軽快な、など)を指定します。
2. キャラの口調に合った「お試し文章(100〜150文字)」を用意する
- ここがとても大事です!Voice Designは渡した文章の内容に合わせて声の演技を変えるため、真面目な説明文を渡すとアナウンサーのような堅い声になり、日常の軽口を渡すと自然な話し声になります。
- 複数候補を生成して聴き比べる
ちなみにWASHABIでは、このプロンプト作成や候補の一括生成、聴き比べプレイヤーの作成もすべてAIエージェントに指示して自動で行っています。人間はAIが並べてくれた候補を聴いて「この声が一番イメージに近い!」と選ぶだけです。
4. 大事な落とし穴:「試聴の声」と「セリフ読み上げの声」が変わる現象と解決法
基本ステップでいい声が作れたあと、ElevenLabsで日本語のキャラボイスを運用するときに一番ハマりやすい落とし穴があります。
それは、「声を作るモデル(v3世代)」と「セリフを自然に読むモデル(v4世代)」が別になっているため、そのまま保存すると声が変わってしまうという現象です。
文章だけだとイメージしにくいので、仕組みと解決ルートを図にまとめました。
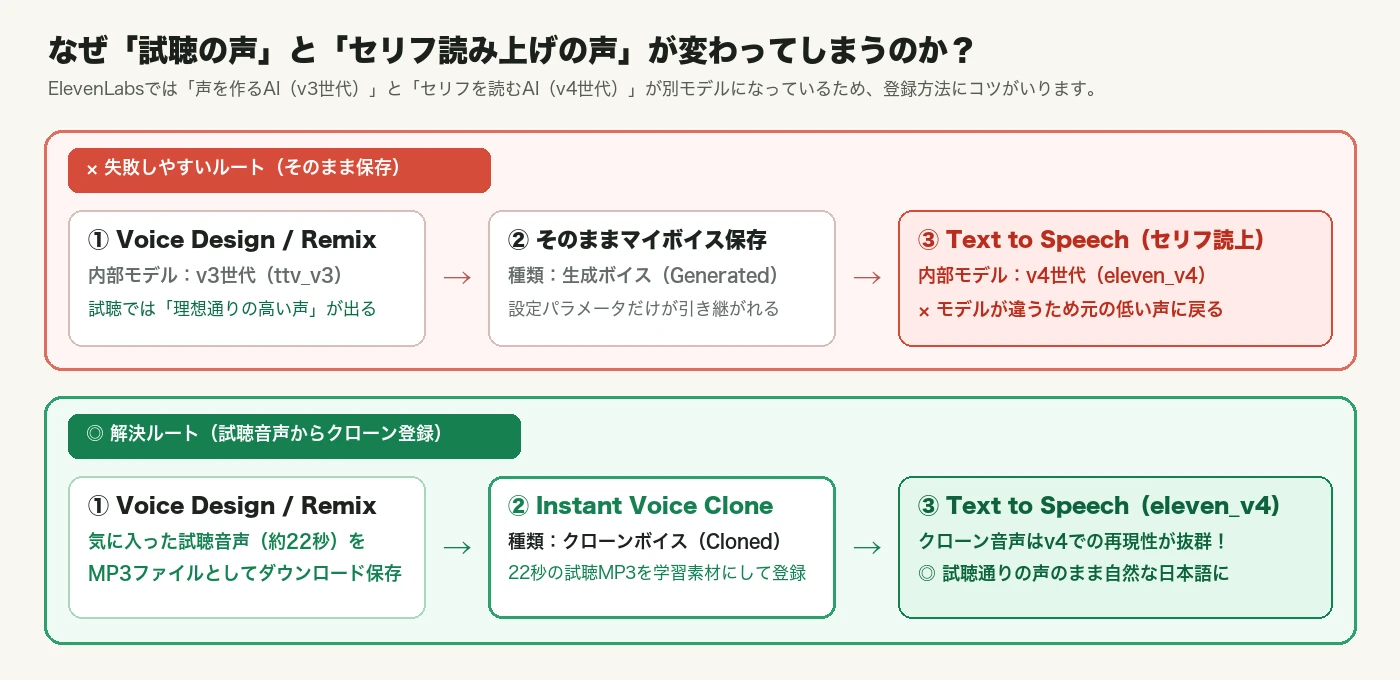
1. 失敗しやすいルート(図の上段)
- Voice DesignやRemixの試聴(v3モデル)で理想の声が出ても、それをそのまま「マイボイス保存(Generated)」してセリフ読み上げ(v4モデル)で使うと、モデルの違いによって元の低い声や別人のようなトーンに戻ってしまいます。
2. 解決ルート:試聴音声(22秒)から「Instant Voice Clone」を作る(図の下段)
- v4モデルは「生成ボイス(Generated)」よりも「実際の音声ファイルからクローンした声(Cloned)」の再現性が圧倒的に高いという特徴があります。
- そこで、Voice Designの試聴で気に入った約22秒の試聴MP3をダウンロードし、それをそのまま「Instant Voice Clone(即時クローン)」に学習素材として登録します。これで試聴通りの声の高さ・軽快さを保ったまま、v4で自然な日本語セリフを喋らせることができます!
5. 実践ログ:ボーカル「ロク」の話し声ができるまで(4段階の聴き比べ)
実際にこの方法でボーカル・ロクの声(ROKU ver2)を作ったときの4段階を聴き比べてみてください。
この試行錯誤も、AIエージェントに「もう少し声を高く、テンポよく軽い声にRemixして比較ページを作って」と指示して進めました。
- ver1(v4読み上げ):最初に作った声。単体では綺麗ですが、ロクの歌声と並べると少し落ち着きすぎていて大人っぽく聞こえました。
- Remix P3-1(v3試聴音声):ver1をベースに「2半音ほど高く、軽快で素早いテンポに」とRemixした試聴音声(22秒)。これが一番ロクのイメージに近い声でした。
- クローンA(v4読み上げ):P3-1の試聴音声+別文章をv3で読ませた計75秒から作ったクローン。余計な音声を足したせいで、少し印象がブレました。
- クローンB=ロク ver2(v4読み上げ):P3-1の試聴音声(22秒)だけから作ったクローン。試聴の明るく軽快な感じがそのままv4で再現できました!
実際にAIエージェントがロクのRemixで使った指示文(英語プロンプト)はこんな感じです。
Keep the same voice identity, timbre, age and native Japanese pronunciation.
Noticeably higher speaking pitch (about two semitones) and a quicker, lighter, more nimble pace.
Natural and relaxed, not excited.声を明るくしようとして energetic や excited を重ねると、文頭が裏返るように上ずってしまいます。
Natural and relaxed, not excited と添えておき、明るさはお試し文章の口調で出す方が自然な声になります。
6. セリフを自然に読ませるコツとまとめ
声(voice_id)が決まったあと、日々の制作でセリフを作るときに押さえているポイントは2つです。
① v4の感情タグは「行頭」に英語で書く
eleven_v4 では、セリフの先頭に [playful]、[cheerful, bright]、[whispers]、[softly] などの英語タグを付けると、声の表情が変わります。
ただし、1〜2秒の短い掛け声に [half-laughing] などの笑い系タグを付けるのはNGです。セリフの前に「フフッ」という笑い声が入り、尺が2.5秒以上に伸びてしまいます。
② 同じ文でも「seed」を変えて3テイク出す
AIの読み上げは1回ごとに微妙なニュアンスや語尾の上がり方が変わります。いつもAIエージェントに頼んで seed(乱数シード)を変えた3テイクを書き出してもらい、一番自然なものを耳で選んでいます。
まとめ:キャラの「話し声」ができると、表現の幅が一気に広がる
- Voice Design(v3) でキャラの口調に合ったお試し文章を読ませて候補を出す
- 気に入った候補の試聴音声(約22秒)から Instant Voice Clone を作る
- v4(
eleven_v4) で感情タグと3テイク比較を使ってセリフを収録する
この流れを作ってから、冒頭で紹介した「サーチライト」の無線ボイスや「まいごみち」の合いの手のように、歌声と違和感のないメンバーの話し声をいつでも収録できるようになりました。ぜひ試してみてください!